技术概述
生物信息学数据挖掘分析是一门融合了生物学、计算机科学、统计学和信息技术的交叉学科技术,主要用于从海量的生物医学数据中提取有价值的信息和知识。随着高通量测序技术、质谱技术和生物芯片技术的快速发展,生命科学研究已经进入了大数据时代,生物信息学数据挖掘分析成为了解读这些复杂数据的关键手段。
从技术原理层面来看,生物信息学数据挖掘分析主要涉及数据的采集、预处理、存储管理、统计分析、模式识别和知识发现等多个环节。其核心目标是通过运用各种算法和计算工具,从基因组、转录组、蛋白质组、代谢组等多组学数据中识别出具有生物学意义的信息,揭示生命活动的分子机制,发现潜在的生物标志物,并为疾病诊断、药物研发和农业生产提供科学依据。
在技术实施过程中,生物信息学数据挖掘分析通常包括以下几个关键步骤:首先是原始数据的质控与预处理,消除实验噪音和系统误差;其次是数据的标准化和归一化处理,使不同来源的数据具有可比性;然后是运用统计学方法进行差异分析、相关性分析和聚类分析;最后结合生物学数据库和知识库进行功能注释和通路富集分析,将计算结果转化为可理解的生物学结论。
现代生物信息学数据挖掘分析技术已经从简单的序列比对和基因注释,发展到整合多组学数据的系统生物学分析。机器学习和深度学习等人工智能技术的引入,进一步提升了数据挖掘的深度和广度,使得从复杂数据中发现隐藏规律成为可能。这些技术进步为精准医疗、个性化用药和转化医学研究提供了强有力的支撑。
检测样品
生物信息学数据挖掘分析所涉及的样品类型非常广泛,几乎涵盖了所有可用于提取生物分子信息的生物样本。根据分析目的和检测项目的不同,可以选取不同类型的样品进行检测分析。
- 组织样品:包括动物组织(如肝脏、肾脏、心脏、脑组织等)、植物组织(如叶片、根、种子等)以及临床手术切除的病变组织,常用于转录组测序和蛋白质组分析。
- 血液样品:全血、血清、血浆等,是临床研究中最常用的样品类型,可用于循环DNA检测、外泌体分析和代谢组学研究。
- 细胞样品:培养的细胞系、原代细胞、干细胞等,广泛应用于功能基因组学研究和药物筛选。
- 微生物样品:细菌、真菌、病毒等微生物纯培养物或环境微生物群落样本,用于宏基因组学和微生物组学研究。
- 体液样品:尿液、唾液、脑脊液、羊水等,可用于代谢组学和生物标志物筛选研究。
- 核酸样品:提取纯化的基因组DNA、总RNA、小RNA、质粒DNA等,是测序分析的直接检测对象。
- 环境样品:土壤、水体、空气悬浮颗粒等环境样本,主要用于环境微生物多样性分析和生态功能研究。
样品的质量对生物信息学分析结果有着决定性的影响。因此,在进行数据挖掘分析之前,需要对样品进行严格的质量评估,包括核酸的完整性、纯度和浓度检测,蛋白质的含量和降解程度评估等,确保后续数据的可靠性和准确性。
检测项目
需要检测,但不确定项目与标准?工程师为您一对一制定检测方案
生物信息学数据挖掘分析涵盖的检测项目非常丰富,根据研究对象和分析层面的不同,可以划分为以下几个主要类别:
- 基因组学分析项目:包括全基因组测序数据分析、全外显子组测序分析、目标区域测序分析、基因组变异检测与注释、拷贝数变异分析、结构变异分析、线粒体基因组分析等。
- 转录组学分析项目:包括mRNA测序分析、长链非编码RNA分析、小RNA测序分析、环状RNA分析、基因表达定量分析、差异表达基因筛选、可变剪接分析、融合基因检测等。
- 表观遗传学分析项目:包括DNA甲基化测序分析、组蛋白修饰ChIP-seq分析、染色质开放性ATAC-seq分析、甲基化差异区域识别等。
- 蛋白质组学分析项目:包括蛋白质定性定量分析、差异表达蛋白质筛选、蛋白质翻译后修饰分析、蛋白质相互作用网络构建等。
- 代谢组学分析项目:包括代谢物定性定量分析、差异代谢物筛选、代谢通路分析、代谢物功能注释等。
- 宏基因组学分析项目:包括微生物物种注释分析、群落结构分析、功能基因注释、抗生素抗性基因分析、代谢通路预测等。
- 单细胞组学分析项目:包括单细胞RNA测序分析、细胞亚群识别、细胞发育轨迹分析、细胞通讯分析等。
- 多组学整合分析项目:包括基因组与转录组整合分析、转录组与蛋白质组关联分析、多组学数据联合通路分析等。
每个分析项目都有其特定的分析流程和技术要求,研究人员需要根据科学问题的实际需求,选择合适的检测项目组合,构建系统完整的研究方案。
检测方法
生物信息学数据挖掘分析的方法体系是由多种计算技术和分析策略组成的综合系统。根据数据类型和分析目标的不同,采用不同的方法组合来实现数据价值的最大化挖掘。
在数据预处理阶段,主要采用质量控制方法对原始数据进行全面评估。针对测序数据,使用FastQC等工具进行碱基质量分布、GC含量、序列重复率等指标的检测;使用Trimmomatic、Cutadapt等工具进行接头序列去除和低质量序列修剪。对于芯片数据,则需要进行背景校正、探针标准化和批次效应校正等处理。
在序列比对与组装方面,根据分析目的选择不同的比对策略。对于有参考基因组的物种,采用BWA、Bowtie2、STAR、HISAT2等工具将测序序列比对到参考序列上;对于无参考基因组的物种,则采用Trinity、SOAPdenovo等工具进行从头组装。比对结果需要进一步进行比对率、覆盖度和均匀性等指标的评估。
在统计分析方法层面,生物信息学数据挖掘分析运用了多种统计学技术。差异表达分析采用DESeq2、edgeR、limma等软件包,基于负二项分布或正态分布模型进行假设检验;功能富集分析采用超几何检验或Fisher精确检验进行统计学显著性评估;相关性分析运用Pearson相关系数、Spearman秩相关系数等指标衡量变量间的关联程度。
聚类分析是生物信息学数据挖掘的重要方法之一,常用的聚类算法包括层次聚类、K-means聚类、自组织映射等,用于识别基因表达模式相似性或样本分组特征。主成分分析和对应分析等降维方法则用于高维数据的可视化和结构解析。
机器学习方法在生物信息学分析中的应用日益广泛。随机森林、支持向量机、神经网络等算法被用于疾病分类预测模型的构建;决策树和逻辑回归用于识别关键特征基因;深度学习技术则在蛋白质结构预测、基因调控网络推断等复杂问题中展现出独特优势。
在功能注释方面,通过比对公共数据库如Nr、Swiss-Prot、KEGG、GO、COG/KOG等,实现基因或蛋白质的功能分类和通路定位。利用BLAST、Diamond等序列比对工具,结合功能数据库的层级分类体系,完成系统性的功能解析。
网络分析方法也是生物信息学数据挖掘的重要组成部分。通过构建蛋白质相互作用网络、基因共表达网络、代谢调控网络等,运用网络拓扑学参数识别关键节点和功能模块,揭示生物系统的协同调控机制。
检测仪器
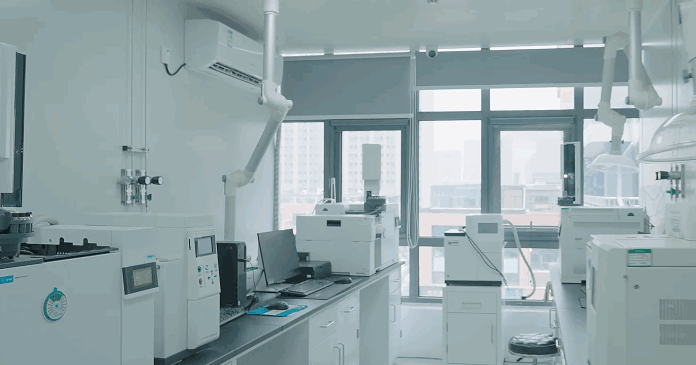
生物信息学数据挖掘分析的数据来源依赖于多种高端检测仪器的支持,这些仪器设备负责产生海量的原始数据,为后续的计算分析提供数据基础。
高通量测序平台是产生测序数据的核心设备。主要包括第二代测序平台如Illumina系列测序仪(NovaSeq、HiSeq、MiSeq等)、Thermo Fisher Scientific的Ion Torrent测序仪等,以及第三代单分子测序平台如PacBio Sequel系列、Oxford Nanopore Technologies的MinION、PromethION等。这些测序仪器能够产生数百万至数十亿级别的测序序列,是基因组学和转录组学研究的主要数据来源。
质谱分析仪是蛋白质组学和代谢组学数据的主要产生设备。常用的质谱系统包括液相色谱-串联质谱联用仪(LC-MS/MS),如Thermo Fisher Scientific的Orbitrap系列、Sciex的TripleTOF系列、Waters的SYNAPT系列等;气相色谱-质谱联用仪(GC-MS),如Agilent的7890B-5977B系统等;以及基质辅助激光解吸电离飞行时间质谱仪(MALDI-TOF MS)等。
生物芯片系统为基因表达谱分析和基因分型提供了另一种技术路线。包括Affymetrix基因芯片系统、Agilent基因芯片平台、Illumina微珠芯片系统等,能够同时检测数万个基因的表达水平或遗传变异。
除了核心检测设备外,配套的样品前处理设备也至关重要。包括全自动核酸提取仪、微量分光光度计(如NanoDrop)、荧光定量仪(如Qubit)、生物分析仪(如Agilent 2100 Bioanalyzer)、片段分析仪、梯度PCR仪、实时荧光定量PCR仪等,用于样品制备和质量控制。
高性能计算平台是生物信息学数据分析的基础设施。由于生物数据量巨大且计算复杂,需要配置高性能工作站或计算集群,配备大容量内存、高速存储和并行计算能力。云计算平台也为大规模生物信息学分析提供了弹性可扩展的计算资源。

应用领域
生物信息学数据挖掘分析技术在生命科学和医学研究的众多领域都发挥着重要作用,其应用范围还在不断扩展。
在基础生命科学研究领域,生物信息学分析被广泛用于解析基因组的结构与功能、揭示基因表达的调控规律、阐明蛋白质的功能与相互作用、探索代谢通路的调控机制。通过比较基因组学分析,可以揭示物种间的进化关系和适应性进化机制;通过功能基因组学分析,可以识别基因的功能元件和调控网络。
在临床医学研究领域,生物信息学数据挖掘分析在疾病的分子机制研究、生物标志物筛选、精准医疗等方面具有重要应用价值。通过分析肿瘤患者的基因组变异谱,可以识别驱动基因突变,指导靶向药物选择;通过整合多组学数据,可以构建疾病预测模型,实现疾病的早期诊断和预后评估;通过分析肿瘤异质性和进化轨迹,可以揭示耐药机制,指导个体化治疗方案制定。
在药物研发领域,生物信息学分析技术贯穿于药物发现和开发的各个阶段。在药物靶点发现阶段,通过基因组学和蛋白质组学分析识别潜在的药物靶点;在药物筛选阶段,通过虚拟筛选和分子对接预测化合物与靶点的相互作用;在临床试验阶段,通过生物标志物分析评估药物疗效和安全性;在药物重定位研究中,通过系统药理学分析发现已有药物的新适应症。
在农业科学领域,生物信息学数据挖掘分析在农作物重要性状的分子解析、分子育种、病虫害防控等方面发挥重要作用。通过全基因组关联分析和数量性状位点分析,可以定位控制产量、品质、抗性等性状的关键基因;通过基因组选择技术,可以加速育种进程;通过分析植物与病原菌的相互作用,可以揭示抗病机制并指导抗病品种培育。
在微生物与发酵工程领域,生物信息学分析技术被用于解析微生物的代谢网络、优化发酵工艺、开发新型生物制品。通过比较基因组学分析,可以识别工业菌株的关键功能基因;通过代谢组学分析,可以监测发酵过程的代谢变化;通过合成生物学设计,可以构建高效细胞工厂生产高价值化学品。
在环境与生态研究领域,生物信息学数据挖掘分析技术被用于研究微生物群落的多样性与功能、环境污染物降解机制、生态系统物质循环等。通过宏基因组学分析,可以揭示环境中微生物的种类组成和功能潜力;通过宏转录组学和宏蛋白质组学分析,可以研究微生物群落的基因表达调控和代谢活性。
常见问题
在进行生物信息学数据挖掘分析的过程中,研究人员常常会遇到各种技术问题和困惑,以下是对常见问题的解答:
- 生物信息学分析对样品质量有什么要求?
样品质量是影响分析结果可靠性的关键因素。对于核酸测序分析,一般要求DNA样品的OD260/280比值在1.8-2.0之间,RNA样品的OD260/280比值在1.9-2.1之间,完整性良好(DNA无降解,RNA的RIN值大于7);对于蛋白质组学分析,要求蛋白质样品纯度高、降解程度低。低质量的样品会导致数据质量下降,影响后续分析的准确性。
- 如何选择合适的测序策略?
测序策略的选择需要根据研究目的和样品特点综合确定。全基因组测序适合全面解析基因组变异;转录组测序适合基因表达谱分析;目标区域测序适合特定基因的深度分析。读长选择方面,短读长测序通量高、准确性好,适合表达谱分析;长读长测序能够跨越重复序列和复杂结构,适合基因组组装和异构体分析。
- 测序数据量如何确定?
测序数据量的确定需要考虑基因组大小、基因数量、表达量动态范围等因素。对于全基因组测序,通常需要30倍以上的测序深度;对于转录组测序,通常需要每样本2000万至5000万条序列;对于小RNA测序,通常需要每样本1000万至2000万条序列。具体数据量还需根据研究目的和预算进行调整。
- 如何评估生物信息学分析结果的可靠性?
评估分析结果可靠性需要从多个角度进行。首先检查数据质量指标,如测序数据的比对率、覆盖度、均一性等;其次检查分析结果的内部一致性,如生物学重复的相关性;然后通过实验验证关键结论,如使用实时荧光定量PCR验证差异表达基因;最后与已发表文献和公共数据库进行比对,确认结果的合理性。
- 如何解读功能富集分析结果?
功能富集分析结果的解读需要结合研究背景和生物学知识。重点关注显著性高、基因数量适中、与研究问题密切相关的功能条目;避免过度解读显著性接近阈值的结果;需要考虑功能条目之间的层级关系和冗余性;建议结合多种功能数据库(GO、KEGG、Reactome等)进行综合分析,获得更全面的功能注释。
- 不同批次的数据能否合并分析?
不同批次的数据合并分析需要谨慎处理批次效应问题。批次效应可能导致真实的生物学差异被掩盖或产生虚假差异。建议在实验设计阶段尽量保持实验条件一致;在分析过程中使用ComBat、limma等算法进行批次校正;对于大规模项目,建议建立标准化的实验流程和数据处理流程。
- 生物信息学分析周期需要多长时间?
分析周期取决于数据类型、数据量、分析内容的复杂程度等因素。一般而言,基础的基因组学和转录组学标准分析需要1-2周时间;复杂的比较分析、多组学整合分析可能需要2-4周甚至更长时间;涉及新方法开发或复杂模型构建的项目可能需要数月时间。
- 如何保障数据的安全性?
数据安全是生物信息学分析中的重要关注点。建议采取数据加密存储、访问权限控制、数据备份恢复等安全措施;对于涉及人类遗传资源的数据,需要严格遵守相关法律法规和伦理要求;建议与具备数据安全管理体系的服务机构合作,确保数据全生命周期的安全管理。
综上所述,生物信息学数据挖掘分析是一门技术复杂、应用广泛的前沿技术,为生命科学研究和医学转化提供了强有力的技术支撑。随着技术的不断进步和应用场景的持续拓展,这一技术将在更多领域发挥更大的作用,推动生命科学研究和生物产业的蓬勃发展。





























